실리콘밸리 개발자가 알려주는 임베딩과 Mini GPT
규칙은 하나도 안 알려줬는데
"고양이" 옆에 강아지가 모였습니다
임베딩 API를 부르는 법은 어디서든 배웁니다. 하지만 결과가 이상할 때 어디를 봐야 하는지는 안을 열어 본 사람만 알아요. 실리콘밸리에서 AI를 개발하는 13년차 백엔드 개발자가, 남이 만든 도구 없이 처음부터 짜면서 그 안을 함께 들여다봅니다.
같은 질문, 다른 대답
"임베딩이요? API 부르면 숫자가 잔뜩 나와요. 그게 뜻을 담고 있다고 하더라고요."
쓸 줄은 압니다. 그런데 왜 그런지, 결과가 이상하면 어디를 봐야 하는지는 모릅니다.
"주변에 같이 나오는 단어를 맞히게 시켜서 만든 숫자예요. 결과가 이상하면 학습을 덜 시켰는지, 숫자 개수가 모자란지부터 봅니다."
원리로 설명하고, 틀렸을 때 어디를 봐야 할지 압니다. 그 차이를 손으로 만듭니다.
매일 쓰는 GPT,
그 안에선 무슨 일이 벌어질까요?
임베딩 API를 호출하면 숫자가 쏟아집니다. GPT가 다음 단어를 만들어 냅니다. ChatGPT는 문맥을 기억합니다. 쓸 줄은 알지만 — "왜 그렇게 동작하는지"
설명하려면 막막해지셨던 적 있지 않으셨나요?
이 강의는 그 안을 직접 들여다봅니다. 설명을 듣는 게 아니라, 코드 한 줄씩 직접 짜면서요.
이 강의는 임베딩·Word2Vec·트랜스포머를 외부 라이브러리 없이 밑바닥부터 구현하는 실습형 AI 강의입니다.
"GPT는 어떻게 다음 단어를 알까요?"
숫자 82만 개짜리 작은 GPT가 직접 써낸 글입니다. 작아서 영어 단어가 온전하진 않지만, "인물 이름 다음에 대사가 온다"는 대본의 생김새는 아무도 안 알려줬는데 스스로 익혔습니다.
문장 안에서 어떤 단어가 어떤 단어를 눈여겨봐야 하는지 계산해서 다음 단어를 고르는 구조입니다. 지금 우리가 쓰는 GPT가 전부 이 구조 위에 있습니다. 이 강의는 그 구조를 처음부터 짜서 위 글을 직접 만들어 냅니다.
"컴퓨터가 '의미'를 어떻게 다룰까요?"
규칙을 준 적이 한 번도 없습니다. "주변에 같이 나오는 단어를 맞혀 봐"라고만 시켰는데 동물은 동물끼리, 음식은 음식끼리 모였습니다. (값은 학습할 때마다 조금씩 달라집니다)
이 결과를 만드는 모델을 직접 학습시킵니다. 딥러닝 프레임워크 없이 TypeScript로, 학습 규칙부터 한 줄씩 짭니다.
"정말 라이브러리 없이 만들 수 있을까요?"
유사도 라이브러리를 부르는 게 아닙니다. 곱하고 더하고 나누는 세 줄이 전부예요. 뜻을 배우는 모델도, GPT도 이렇게 핵심을 한 줄씩 직접 짭니다.
도구를 갖다 쓰지 않고 핵심을 한 줄씩 직접. 끝에는 "내가 짠 임베딩 모델과 내가 짠 미니 GPT"가 손에 남습니다.
“
라이브러리를 import하는 법은 어디서든 배웁니다.
이 강의는 그 안에서 무슨 일이 벌어지는지, 결과가 이상할 때 어디를 의심해야 하는지를 손으로 익힙니다.
그 감각이 결국 실력의 차이를 만듭니다.
강사
실리콘 밸리 개발자 Waddy
13년차 백엔드 서버 개발자입니다. 국내 여러 기업을 거쳐 지금은 실리콘 밸리에서 AI 관련 개발을 하고 있습니다.
임베딩 API를 부르는 법은 어디서든 배울 수 있습니다. 하지만 결과가 이상할 때 어디를 봐야 하는지는 안을 열어 본 사람만 압니다. 그 차이를 만드는 과정을 그대로 옮겼습니다. 제가 아는 것을 최대한 쉽고 편하게 전달하겠습니다.
"임베딩 API를 호출하는 법이 아니라, 그 숫자가 어떻게 만들어지는지를 가르치고 싶었습니다. 강의를 준비하며 제가 직접 다시 짜 보니, 예전엔 몰랐던 디테일이 새로 보이더라고요. 그 과정을 그대로 여러분과 함께 갑니다."
그래서,


직접 만드는 순서가 궁금하다면
무엇을 만들고 무엇이 손에 남는지 먼저 보세요
만드는
뜻을 숫자로 다루는 법부터 시작해, 뜻을 배우는 모델과 글을 쓰는 모델을 차례로 만듭니다.
뜻을 숫자로 다루는 법 TypeScript
두 문장이 얼마나 가까운지를 숫자로 재는 방법부터 짭니다. 공식을 외우는 게 아니라 코드로 계산해 보면서 감을 잡습니다. (벡터·코사인 유사도·분포 가설)
뜻을 배우는 모델 직접 만들기 TypeScript
"주변에 같이 나오는 단어를 맞혀 봐"라고만 시켜서 단어의 뜻을 익히게 합니다. 도구 없이 처음부터 짜고, 동물은 동물끼리 음식은 음식끼리 모이는 걸 눈으로 봅니다. (Word2Vec·skip-gram)
모델이 스스로 고쳐 나가는 장치 만들기 TypeScript
답이 틀렸을 때 어느 숫자를 얼마나 고쳐야 하는지 계산해 주는 부품입니다. 딥러닝 프레임워크가 대신 해 주는 그 일을 직접 짜고, 그걸로 작은 신경망을 학습시킵니다. (자동 미분·역전파)
글을 쓰는 미니 GPT 만들기 Python + PyTorch
문장 안에서 어떤 단어가 어떤 단어를 봐야 하는지 계산하는 구조를 처음부터 짭니다. 셰익스피어 대본을 먹여 학습시키고, 오차가 줄어들면서 글이 나오기 시작하는 걸 직접 봅니다. (트랜스포머·self-attention)
글을 조각내는 법과 문장 단위 뜻 다루기 Python
긴 글을 모델이 먹기 좋은 조각으로 나누는 규칙을 직접 만듭니다. 그다음 단어가 아니라 문장 하나를 통째로 숫자로 바꾸는 데까지 갑니다. 우리가 흔히 갖다 쓰는 임베딩 모델이 어떻게 만들어지는지 알게 됩니다. (BPE·문장 임베딩)
포트폴리오와 이력서에 씁니다
"OpenAI 임베딩 API를 사용했습니다"와 "파라미터 82만 개짜리 트랜스포머를 프레임워크 없이 직접 구현했습니다"는 다른 문장입니다. 뒤쪽을 쓰려면 안을 열어 봐야 하고, 이 강의가 그 과정이에요.
여섯 줄 모두 이 강의에서 직접 만들고 직접 재는 것들입니다. 면접에서 "그래서 안에서 무슨 일이 일어나나요"라는 질문이 들어와도 답할 게 남습니다.
백 마디 설명보다,
이론 슬라이드가 아니라 실제 코드를 짜는 화면입니다. 미니 GPT를 한 줄씩 완성해 가는 과정을 미리 확인하세요.
FFN 블록부터 미니 GPT까지, 코드로 직접 완성합니다
피드포워드 네트워크 묶음을 위한 블록과 미니 GPT 설계를 코드로 한 줄씩 작성합니다. 각 줄마다 왜 이렇게 짜는지 주석으로 하나하나 설명해요. 다 만든 결과가 아니라, 만들어 가는 과정을 그대로 담은 강의 실제 화면입니다.
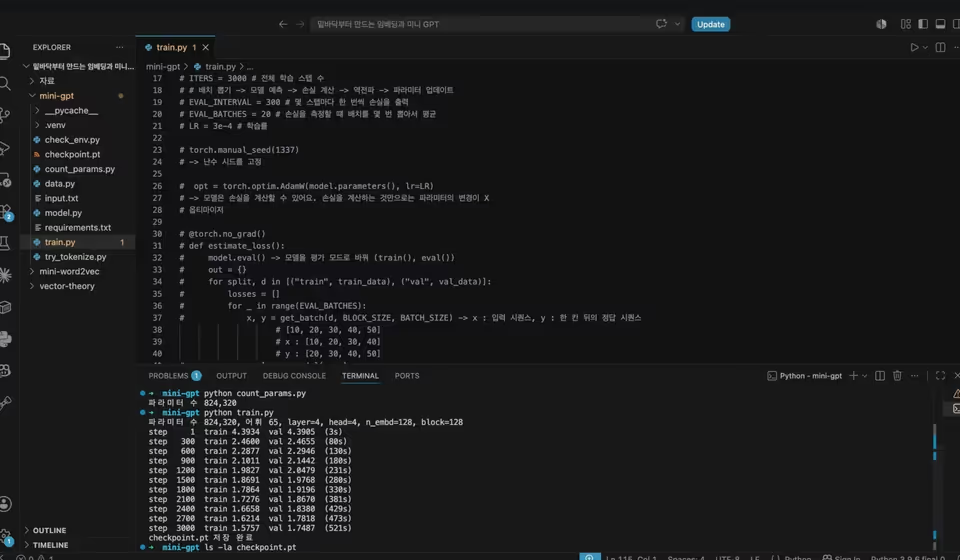
지금 쓰는 AI가 위에 있습니다
이 강의에서 82만 개짜리로 짜는 그 구조가, ChatGPT와 Claude와 Gemini가 올라가 있는 바로 그 구조예요. 크기만 다릅니다.
이 흐름에서 API를 부를 줄 아는 사람은 이미 많습니다. 부족한 쪽은 결과가 이상할 때 안을 열어 볼 수 있는 사람이에요. 그 차이는 한 번이라도 직접 짜 봤는지에서 갈립니다.
출처: OpenAI 공식 발표(2026년 2월, 주간 활성 사용자) · Sensor Tower State of AI 2026(Claude 월간 활성 사용자) · Anthropic 발표(Fortune 100 고객 비중) · Semantic Scholar 인용 수(2026년 초 기준)
이런 분께
아래 하나라도 해당되면, 이 강의는 바로 쓸모가 있습니다.
이런 분이라면 꼭
- AI가 안에서 어떻게 도는지 코드 수준까지 알고 싶은 개발자
- AI를 쓰고 있지만 "왜 이렇게 동작하는지" 설명이 어려운 분
- 라이브러리 사용을 넘어 원리를 직접 구현해 보고 싶은 분
- GPT 같은 걸 한 번쯤 직접 짜 보고 싶었던 분
- AI 모델이 예상과 다르게 동작할 때 어디서부터 봐야 할지 감각을 키우고 싶은 분
직접 짠 코드가
아래 숫자는 강의에서 실제로 돌려 나온 값을 그대로 옮긴 것입니다.
WORD2VEC · 강의 E
흩어져 있던 단어가 의미끼리 모입니다
문장 150개를 직접 짠 학습 코드로 돌렸습니다. 예측이 틀린 정도가 0.69에서 0.16까지 내려가고 나면, "자동차"를 물었을 때 자전거·지하철·기차·버스가 0.970~0.995로 붙어 나옵니다.
BPE 토크나이저 · 강의 F
같은 문장이 절반 이하로 줄어듭니다
자주 붙어 다니는 글자 쌍을 합치는 규칙을 50개만 배우게 했는데도 조각 수가 절반 이하로 줄었습니다. 한 번에 읽힐 수 있는 분량이 두 배 넘게 늘어난다는 뜻입니다.
이 강의가
둘 다 설치만 하면 무료로 돌아갑니다. 계정도, 결제도, GPU도 필요 없습니다.
미니 GPT와 나머지를 Python + PyTorch로 만듭니다. 다만 빌리는 건 숫자 계산과 학습 도우미까지입니다. 문장 안에서 무엇을 봐야 하는지 계산하는 부분은 전부 직접 짭니다. 그래야 안이 보이니까요.
llama3.2와 bge-m3를 내 노트북에서 띄웁니다. API 키도 요금도 없습니다. 마지막에는 직접 만든 82만 개짜리 미니 GPT를 여기 올려둔 거대 모델과 나란히 놓고 무엇이 다른지 봅니다.
앞쪽 세 파트는 TypeScript로, 뒤쪽 두 파트는 Python + PyTorch로 진행합니다. 두 언어 다 기본 문법을 읽을 수 있으면 따라오실 수 있습니다.
사전 지식 &
거창한 준비는 필요 없습니다. 노트북 한 대면 시작할 수 있어요.
TypeScript 또는 Python 기본
변수, 함수, 반복문 정도면 충분합니다. 수학이나 딥러닝 이론은 강의 안에서 필요한 만큼만 짚습니다. 다른 강의를 먼저 들을 필요 없습니다.
macOS
강의는 macOS(zsh·Homebrew) 기준으로 진행합니다. 임베딩·LLM은 모두 로컬(Ollama)에서 무료로 돌립니다. GPU 없이도 완주할 수 있습니다.
외부 결제 0원
OpenAI 같은 유료 API 키가 필요 없습니다. GPU도, 클라우드 서버도 필요 없습니다. 오픈소스와 로컬 모델(Ollama·bge-m3·llama3.2)만으로 처음부터 끝까지 완주합니다.
자주 묻는
수강 전에 가장 많이 궁금해하시는 것들을 모았습니다.
Q.수학을 잘 못하는데 따라갈 수 있나요?
⌄
Q.TypeScript랑 Python 둘 다 필요한가요?
⌄
Q.GPU가 있어야 하나요?
⌄
Q.Ollama가 뭔가요? 따로 설치해야 하나요?
⌄
Q.PyTorch를 한 번도 안 써봤는데 괜찮을까요?
⌄
Q.다른 강의(RAG 완전정복)를 먼저 들어야 하나요?
⌄
지금 바로 시작하세요
GPT 안을 직접
들여다보는 여정,
코드 한 줄씩 함께 만들어 갑니다.
외부 API 없이, GPU 없이, 처음부터 끝까지 로컬에서 완주합니다.
혼자 듣고
배움은 강의 밖에서도 이어집니다. 개발자들이 모여 커리어 고민, 현업의 상황, 기술 이야기를 자유롭게 나누는 카카오톡 오픈채팅과, 개발 이야기를 올리는 Threads 계정을 운영하고 있어요. 강의를 듣다 막힌 부분도 편하게 물어보세요.
Hong의 개발 이야기, Threads에서
개발하면서 겪은 이야기와 새 강의 소식을 올리고 있어요. 팔로우해 두시면 피드에서 바로 받아보실 수 있습니다.
Threads 팔로우하기